


Agnieszka Gorgoń-Komor pyta o dane osobowe i prawa autorskie w AI
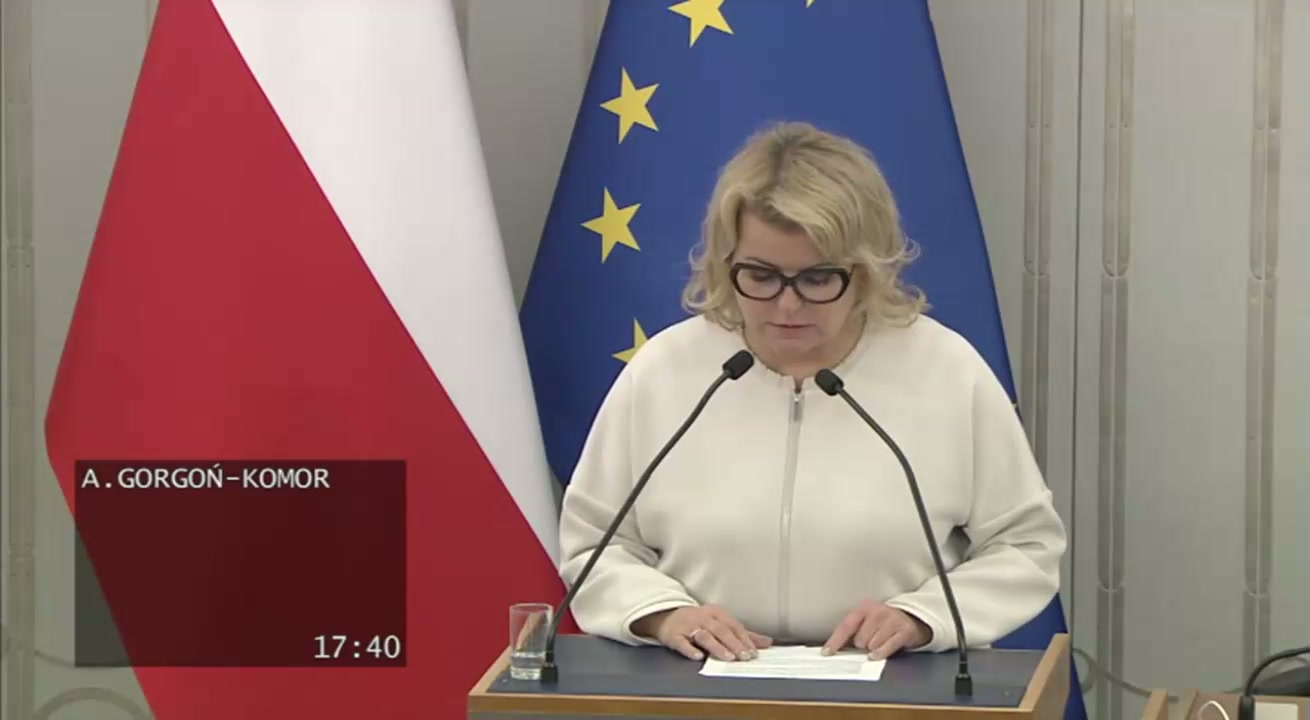
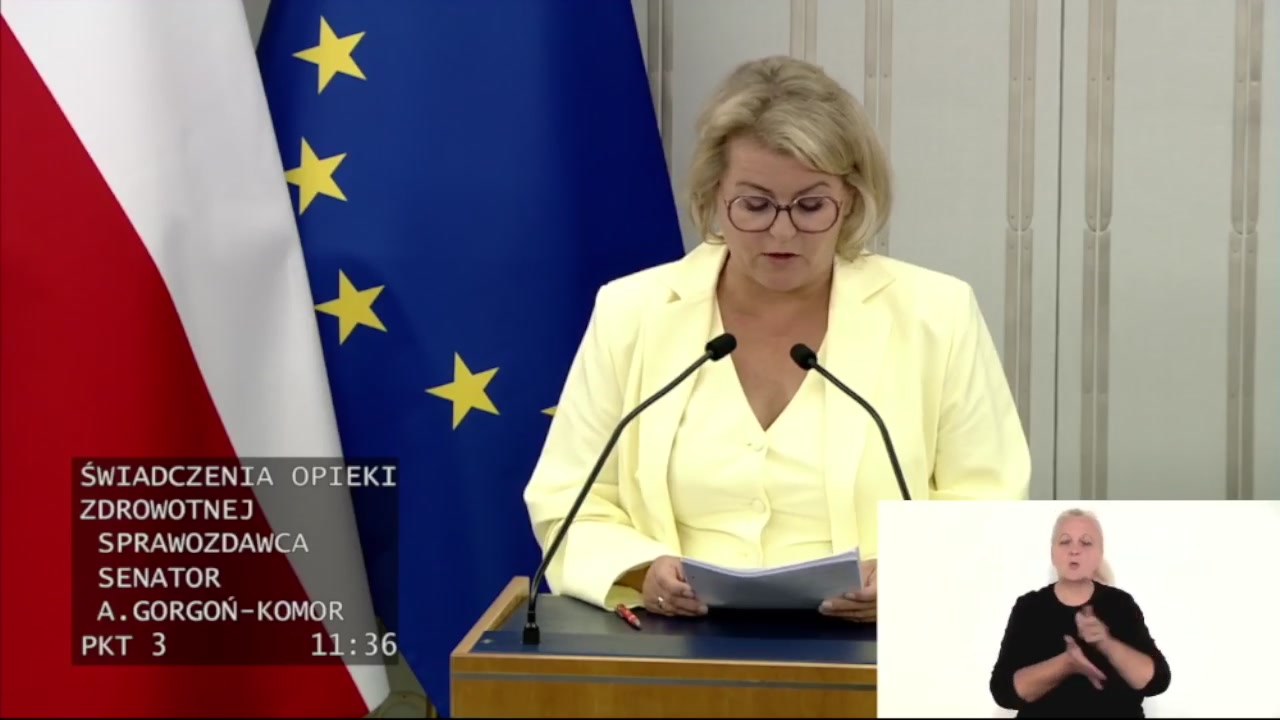
Senator Agnieszka Gorgoń-Komor zadaje dwa pytania dotyczące sztucznej inteligencji: o zabezpieczenie poufnych danych przed wyciekiem do publicznych modeli oraz o własność intelektualną materiałów tworzonych przez AI. Nagranie zawiera jej pytania i odpowiedź rozmówczyni.
W pierwszym pytaniu senator porusza zakres odpowiedzialności za ochronę danych podczas wdrażania narzędzi generatywnych. W odpowiedzi padają odniesienia do kompetencji Prezesa Urzędu Ochrony Danych Osobowych oraz współpracy przy tworzeniu dobrych praktyk.

W pierwszym pytaniu senator porusza zakres odpowiedzialności za ochronę danych podczas wdrażania narzędzi generatywnych. W odpowiedzi padają odniesienia do kompetencji Prezesa Urzędu Ochrony Danych Osobowych oraz współpracy przy tworzeniu dobrych praktyk.
Udostępniamy tysiące materiałów, by polityka była przejrzysta i odporna na manipulacje. Widzisz błąd? Zgłoś go — razem budujemy rzetelne archiwum polskiej polityki.
Inne wystąpienia

Tego samego dnia Wszystkie wystąpienia z tego dnia →
PiS
PiS: Gębicka żąda odwołania Krajewskiego za sytuację w rolnictwie
Donald Tusk
Konferencja prasowa Premiera Donalda Tuska i Premiera Bułgarii Rumena Radewa
PiS
Posłowie PiS: "Bronimy Trybunału przed bandą Tuska"
Stanisław Gawłowski
Stanisław Gawłowski: Koszalin czeka na nowy dworzec
Krzysztof Bieńkowski
Krzysztof Bieńkowski pyta o sens kolejnego urzędu ds. AI
Krzysztof Kwiatkowski
Krzysztof Kwiatkowski pyta o ekrany akustyczne przy A1
Artykuły

Transkrypcja
Dziękuję bardzo. Pani senator Agnieszka Gorgoń-Komor.
Ja mam dwa krótkie pytania. Pierwsze to jest o ochronę danych osobowych.
Czy w pani kompetencji jest zabezpieczenie poufnych danych,
które mogą wycieknąć do modeli publicznych w czasie wdrażania narzędzi generatywnych?
I drugie pytanie to jest o prawa autorskie. Z perspektywy pani, jak
powinno się rozwiązać kwestie własności intelektualnej
materiałów tworzonych przez sztuczną inteligencję? Dziękuję bardzo.
Dziękuję. Kwestia danych osobowych oczywiście w ramach tego,
gdzie one znajdują się w systemach sztucznej inteligencji.
Tutaj jest we współpracy pomiędzy Komisją, a także Urządem Ochrony
Danych Osobowych i Prezesem Urzędu Ochrony Danych Osobowych,
z którym należy nawiązać bliską współpracę, dlatego, że ten obszar
używania danych osobowych jest bardzo szeroki. W sztucznej inteligencji,
szczególnie w tej, którą znamy najbardziej, czyli chatboty, z którymi
rozmawiamy, często chcemy albo używamy tych danych osobowych.
Więc takie i najlepsze praktyki, ale oczywiście muszę wspomnieć,
że zakres ochrony danych osobowych jako takich pozostaje oczywiście
w kwestii Prezesa Urzędu Ochrony Danych Osobowych. Ale takie
najlepsze praktyki na pewno we współpracy należy tworzyć.
Jeżeli chodzi o prawa autorskie, no to prawa autorskie, jeżeli chodzi
o polski reżim prawny, są określone na poziomie europejskim
w dyrektywie DSM, która została wdrożona w polskim prawie i oznacza
kwestię tzw. opt-outu, czyli jeżeli twórca chce, żeby jego praca
nie była użyta do trenowania modelu, może zaznaczyć to, jest to opisane
w różny sposób, zazwyczaj jest coś takiego jak robots.txt, taki plik,
który można oznaczyć, jeżeli to jest środek cyfrowy, że nie chcemy,
żeby nasze dane zostały użyte w procesie trenowania. Jednak nie ma
żadnego sposobu np. monetyzacji treści. Wiele twórców chciałoby
sprzedać swoją treść po to, żeby mogła być użyta w trenowaniu
modeli sztucznej inteligencji. Są takie projekty na poziomie
Unii Europejskiej, tzw. LDS, Language Data Space, przestrzeń danych językowych,
które mają umożliwić taką kwestię, więc chciałabym na pewno
współpracować z tymi jednostkami, żeby zobaczyć, czy właśnie jest
takie miejsce i przestrzeń na stworzenie takiego mechanizmu
monetyzacji tych treści. Jednak oczywiście wszystkie inne kwestie
związane, bo jednak to są kwestie połączone, rzeczy wrzucamy do modelu,
np. nasze dane osobowe, a później wychodzi z tego jakaś treść,
która także możemy wykorzystać. Oczywiście, jeżeli zmienimy tę treść,
czyli jeżeli wygenerujemy sobie jakiś fragment tekstu albo wesprzemy się
sztuczną inteligencją, to to też jest ważne, że my możemy nadal być twórcą
takiego dzieła. Więc oczywiście też jest ważne w zakresie wyjaśnień,
żeby każdy miał pewność, do czego może mieć prawo i gdzie w zakresie
wyjaśnień i wykorzystania tych danych oraz generowania tych danych
leży obowiązek na kimś, kto korzysta z AI albo z kimś, kto trenuje AI.
Dziękuję.